


L'audio è parte integrante di molte applicazioni IoT, tra cui prodotti di consumo come altoparlanti e cuffie, dispositivi indossabili e dispositivi medici (EG, apparecchi acustici), automazione e applicazioni di controllo industriale, sistemi di intrattenimento e unità di infotainment automobilistiche.
L'audio IoT può essere ampiamente classificato in tre tipi: streaming (cioè musica, voce e dati), riconoscimento/comandi vocali e wireless tramite connettività Bluetooth e Wi-Fi (ad es. Streaming Audio multicanale su Wi-Fi a un sistema audio surround). Tuttavia, la progettazione di sottosistemi audio acustici ininterrotti di alta qualità può essere impegnativo quando gli ingegneri devono aderire ai rigorosi vincoli richiesti per i dispositivi basati sull'IoT.
Sono necessari progetti più complessi per includere funzionalità avanzate come il riconoscimento vocale, come consentire ai conducenti di controllare il sistema di infotainment nella propria auto nello stesso modo a mani libere di un telefono cellulare. Poiché l'MCU è al centro di tutti questi sistemi audio, è importante selezionare un MCU che integra le tecnologie audio necessarie necessarie per progettare un sistema audio affidabile senza rumore. Questo documento esplora le tecnologie audio che possono essere utilizzate per progettare tali sistemi.
Componenti di un sottosistema audio
L'audio IoT prevede tre attività principali: voce/dati di alta qualità, trasmissione wireless e controllo della riorganizzazione vocale. La Figura 1 mostra i blocchi di costruzione più importanti in un sistema incorporato.
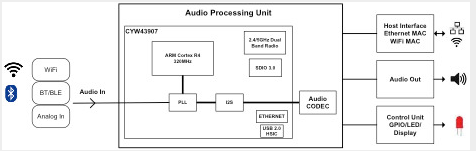
Questo diagramma a blocchi mostra i blocchi di costruzione più importanti del sottosistema di elaborazione audio
Si noti che molte di queste caratteristiche possono essere integrate nel moderno MCU, come il Cypress CyW43907 con Wi-Fi integrato 802.11n utilizzato in questo esempio. Alcune delle importanti tecnologie audio che possono essere incluse in un sistema basato su IoT includono:
Applicazioni musicali
Gli MCU abilitati audio consentono agli ingegneri di decodificare i flussi MP3/4 utilizzati dai giocatori di media e dai fornitori di contenuti più popolari. Molti design devono anche supportare la decodifica AAC di WMA e Apple, che richiede ulteriore potenza di elaborazione. Nelle applicazioni audio di consumo, gli MCU audio a basso costo possono spesso essere utilizzati gestendo flussi di musica digitale da accessori audio come set di altoparlanti digitali.
In queste applicazioni, un frame di dati audio PCM (incapsulati in un formato di classe audio USB) arriva ogni 1 ms attraverso uno dei canali seriali SPI/I²C del processore. A seconda della fonte, il flusso audio può arrivare in uno dei numerosi formati (cioè allineato a sinistra, allineato a destra, I2S, ecc.). Tuttavia, alcuni codec a basso costo possono accettare solo determinati formati. In questi casi, l'MCU svolge un ruolo importante nel garantire che i dati siano correttamente allineati prima che vengano alimentati al codec.
Poiché non tutte le fonti audio utilizzano la stessa velocità di campionamento, il codec deve anche adattare la sua frequenza di campionamento alla sorgente o fare affidamento sull'MCU per convertire il flusso di dati campionato in una velocità di dati comune (vedere la Figura 2). In questi casi, l'MCU deve gestire il flusso per evitare condizioni di sottovalutazione o sovraccarico che possono portare a muti, POP e discontinuità audio che possono causare perdita di dati e interrompere l'esperienza di ascolto dell'utente. Si noti che l'MCU audio può anche essere utilizzato per implementare altre funzioni del sottosistema audio, come il controllo dell'illuminazione durante la riproduzione audio.
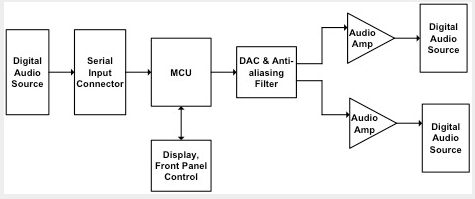
Potrebbe essere necessario eseguire la conversione del formato, la regolazione della velocità di campionamento e la gestione del flusso, nonché di supportare le interfacce utente audio.
Per implementare l'audio in una vasta gamma di applicazioni, gli MCU audio devono supportare una varietà di tecnologie audio. La Figura 3 mostra esempi di queste tecnologie audio.
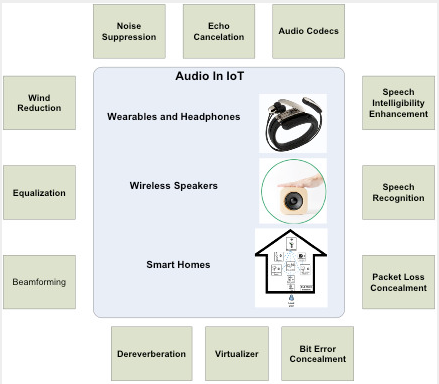
tecnologia sonora
Codec audio
I codec audio sono il componente frontale principale di un sistema audio. Molti MCU creati per applicazioni IoT supportano la funzionalità di codec nell'hardware. Ciò consente al sistema di ridurre le dimensioni dei campioni audio digitali di accelerare la trasmissione wireless (potenza di risparmio) e salvare lo spazio di archiviazione (riducendo la deformazione sulla capacità di memoria interna). Il codec può supportare vari formati standard audio come AAC, AC -3 e ALAC. Per fare ciò, richiede un'unità di accesso di decodifica (AU), che viene implementata prima di qualsiasi post-elaborazione audio (ad esempio, dsola, sola). Se utilizzato con formati audio standard come AAC, AC -3 e ALAC, l'audio è classificato in modo tale che i successivi campioni audio si trovino all'interno del formato prescritto specificato nel flusso di dati del pacchetto audio. La spaziatura dei pacchetti è inoltre gestita per consentire un ottimo jitter trasversale e un funzionamento ininterrotto in presenza di congestione. La dimensione del payload AU consente l'esecuzione di qualsiasi occultamento che deve essere eseguito.
Elaborazione della banda di base
Un segnale della banda di base è il gruppo fondamentale di frequenze in una forma d'onda analogica o digitale che può essere elaborata da circuiti elettronici. Un segnale della banda di base può consistere in una singola frequenza o un gruppo di frequenze o, nel dominio digitale, un flusso di dati inviati su un canale non multiplessato. La banda base è definita come la banda di base (segnale/secondo) miscelata con il segnale portante per produrre un segnale modulato. Si noti che in MCUS supportano Audio IoT, il codec audio integra l'elaborazione della banda base e la RF su un singolo chip. Il codec audio può essere implementato in una varietà di ricetrasmettitori wireless per fornire dati vocali e/o funzionalità musicale. Il codec presenta anche canali mono e stereo per l'uscita audio e gli ingressi stereo.
Concmenti di perdita di pacchetti e replica dei dati
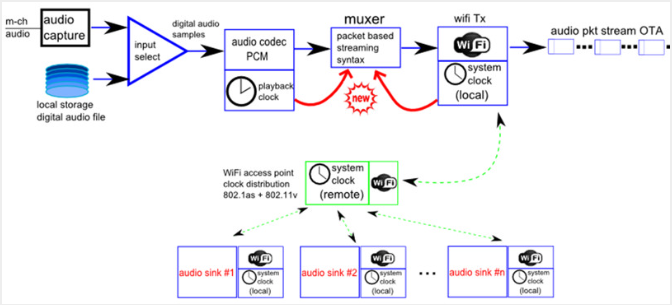
Latenza eccessiva, perdita di pacchetti e jitter ad alta latenza possono compromettere la qualità della comunicazione. La probabilità di una perdita improvvisa dei pacchetti aumenta con il carico di rete e provoca interruzioni che possono essere ascoltate dall'utente. La robusta trasmissione audio su Wi-Fi può essere migliorata con funzionalità avanzate come la tecnologia di occultamento della perdita di pacchetti di Cypress. L'origine/ricevitore dell'architettura del sistema è la seguente: una sorgente cattura l'audio, multiplex dei dati PCM attraverso la struttura del flusso RTP e sincronizza l'orologio con tutti i ricevitori collegati alla sorgente PLC.
Si noti che le prestazioni del collegamento di comunicazione dipendono dalla qualità delle prestazioni del budget del collegamento. Questo budget di collegamento è determinato da tre fattori: trasmettere la potenza, trasmettere il guadagno dell'antenna e ricevere il guadagno dell'antenna. Ad esempio, la comunicazione affidabile su una rete 802.11 è possibile se la potenza del percorso di collegamento meno la perdita di spazio disponibile è maggiore del livello minimo di segnale ricevuto della radio ricevente (vedere Figura 4).
Le prestazioni di un collegamento di comunicazione dipendono dalla qualità delle prestazioni del budget del collegamento
Speech Intelly Intelly Miglioramento (SIE)
Il rumore di fondo nel sistema audio può ridurre l'intelligibilità del linguaggio. Se il rumore supera un certo livello, il discorso può essere difficile da capire per l'utente. La disponibilità del riconoscimento vocale continuo in tempo reale su dispositivi incorporati richiede un sistema che migliora l'intelligibilità del discorso con problemi di rumore. La selezione di un MCU che supporta il porting e l'ottimizzazione di un sistema di riconoscimento vocale del vocabolario di grandi dimensioni comunemente usato (LVCSR) può semplificare lo sviluppo.
Rilevamento delle frasi di risveglio
Questa funzione avanzata consente agli utenti di attivare il sistema a mani libere attivando il dispositivo con la loro voce.
Efficiente multicast a uno o più altoparlanti
Il multicasting è un metodo di indirizzamento della rete utilizzato per inviare messaggi a un gruppo di obiettivi contemporaneamente utilizzando la strategia più efficiente. I messaggi vengono consegnati una sola volta tramite ciascun collegamento nella rete e le copie vengono create solo quando il collegamento successivo si divide in più destinazioni, di solito su switch di rete e router. Tuttavia, come l'User Datagram Protocol (UDP), il multicast non garantisce la consegna del flusso di messaggi, che può portare a scartare i messaggi o consegna di messaggi non organizzati. Il multicast affidabile (RMC) fornisce riconoscimenti per i pacchetti multicast (solo pacchetti) in modo che alcuni pacchetti multicast specifici possano essere consegnati in modo affidabile. Il trasmettitore seleziona il ricevitore con l'RSSI più debole per riconoscere il frame. In un ambiente IoT, l'implementazione di RMC significa che il trasmettitore Wi-Fi sceglie uno dei tanti ricevitori Wi-Fi per riconoscere la ricezione dei frame. Il trasmettitore seleziona il ricevitore con l'RSSI più debole per riconoscere il frame. L'implementazione utilizza un quadro operativo contenente elementi di informazione RMC proprietari per avvisare e consentire il riconoscimento. L'implementazione contiene anche comandi driver Wi-Fi specifici per RMC per impostare l'indirizzo MAC multicast e per abilitare e disabilitare l'RMC.
Per audio e video con ritardi di trasmissione fissi e simmetrici, vengono soddisfatti i requisiti di sincronizzazione del tempo; Ad esempio, RMC può fare affidamento su tempi e sincronizzazione altamente accurati per la trasmissione liscia da cellula a cellula di dati vocali, video e mobili. Il raggiungimento di tempi altamente precisi e precisi non è facile da un punto di vista tecnico, quindi è importante trovare implementazioni che possono essere verificate per soddisfare i requisiti di applicazione.
Formati di inquadratura, correzione degli errori in avanti e replica dei pacchetti
Per lo streaming audio, è fondamentale che l'orologio sia sincronizzato con tutti i ricevitori Wi-Fi. Un approccio è quello di utilizzare un orologio comune per i dispositivi di origine e ricevitore, spesso chiamato orologio da parete o orologio di sistema (STC). Innanzitutto, ogni ricevitore (ricevitore) sincronizza il suo STC (orologio da parete) con la STC di sorgente/trasmettitore (orologio da parete principale). Ogni ricevitore può ora recuperare l'orologio del trasmettitore perché il timestamp inserito dalla sorgente (disponibile nell'intestazione estesa di ciascun pacchetto RTP) riflette il momento campionato del supporto rispetto all'orologio comune.
L'STC si basa sui valori dell'orologio del Grandmaster descritti nella specifica 802.1AS. Poiché tutti i dispositivi del ricevitore sono consapevoli della correlazione tra STC e l'orologio multimediale del dispositivo di origine (in quanto si riferisce a RTP o Timestamp multimediale), ogni ricevitore può ricostruire una copia dell'orologio multimediale RTP del dispositivo di origine e mettere la sua uscita di conseguenza per il corretto rendering. Il clock trasparente è il luogo in cui l'hardware/UCODE può essere pacchetti di timestamp ricevuti e trasmessi il più vicino possibile all'interfaccia MAC/PHY. Sebbene questo valore di clock non sia utilizzato per la riproduzione, può essere utilizzato per misurare il jitter in tutto il sistema ed eseguire un'analisi delle prestazioni complete.
Esempio di un sistema audio domestico intelligente
Per comprendere l'audio IoT nel contesto, considera l'esempio della casa intelligente e il ruolo che audio può svolgere per migliorare la funzionalità generale di un sistema domestico intelligente. Una casa diventa una casa intelligente quando i dispositivi e gli elettrodomestici possono comunicare tra loro e le persone che vivono lì. Aumentando la nostra interconnettività, le case intelligenti stanno migliorando la nostra qualità di vita e aumentando la nostra sicurezza.
Uno dei principali casi d'uso per l'audio nella casa intelligente è la memorizzazione e la condivisione dell'audio su Wi-Fi o Bluetooth. La scelta del Wi-Fi su BLE varia in base all'applicazione e dipende dai requisiti di qualità e di qualità audio. Ad esempio, un controller di casa può suonare un suono specifico in ogni stanza della casa se qualcuno suona il campanello sulla porta, piuttosto che semplicemente collegare la campana in una parte della casa. Allo stesso modo, il controller può limitare il suono a stanze specifiche, come non in un vivaio per i bambini. I controller incorporati aiutano a elaborare questo audio e rendere il sistema più intelligente gestendo varie funzioni di controllo dell'output.
Sistemi audio di riproduzione
Replay Audio Systems è diventato un'applicazione importante nel mercato audio. I sistemi di replay audio wireless sono al centro della casa intelligente, riunendo molti diversi dispositivi intelligenti nella casa e prendendo decisioni intelligenti per conto dell'utente. Ad esempio, un sistema audio può controllare i modelli di illuminazione in una casa basata sulla musica che sta attualmente suonando. Può anche utilizzare la conversione di testo-linguaggio per leggere le notifiche dell'utente o e-mail ad alta voce. Gli utenti hanno anche la possibilità di creare zone in un sistema audio multi-room utilizzando dispositivi audio di rete, come altoparlanti wireless in diverse stanze della casa. Questo approccio crea un intero ecosistema per garantire che la casa operi sempre al massimo dell'efficienza minimizzando le interazioni con le persone che vivono lì. Per creare un tale ecosistema, i progettisti IoT devono selezionare un microcontrollore incorporato con le giuste prestazioni e funzionalità basate su audio che sono state ottimizzate per le applicazioni IoT.
Effetti di elaborazione del segnale digitale
L'elaborazione del segnale audio nel dominio digitale è una parte importante di qualsiasi sistema audio prima di trasmettere dati audio su un collegamento wireless. Questa elaborazione prevede in genere la misurazione, il filtraggio e/o la composizione del segnale analogico audio. Gli MCU incorporati con funzionalità DSP integrata abilitano effetti come l'aggiunta di un mixer digitale e il supporto per le funzioni di controllo remoto. Con un equalizzatore della banda 5- per ciascun canale, la riproduzione audio può essere intelligentemente integrata con la maggior parte delle applicazioni sequencer per creare un potente sistema in studio.